Alzi la mano chi non ha mai utilizzato l’intelligenza artificiale per lavoro.
Oppure: alzi la mano chi si è chiesto cosa poteva avvenire dei dati inseriti, prima di farlo.
Probabilmente si vedrebbero ben poche mani alzarsi…
Stiamo parlando dei chatbot, quelli che da alcuni anni, a partire da ChatGPT, hanno invaso i nostri ambienti digitali, e che sono noti sotto il nome collettivo di “intelligenza artificiale”; più propriamente sono LLM (Large Language Models), cioè sistemi che manipolano (e generano) testi.
Comodi, comodissimi.
Però…
Ci sono tantissimi “però”, ma qui ci concentriamo su uno, quello che ci compete: la protezione dei dati personali.
Cosa succede ai dati di utilizzo?
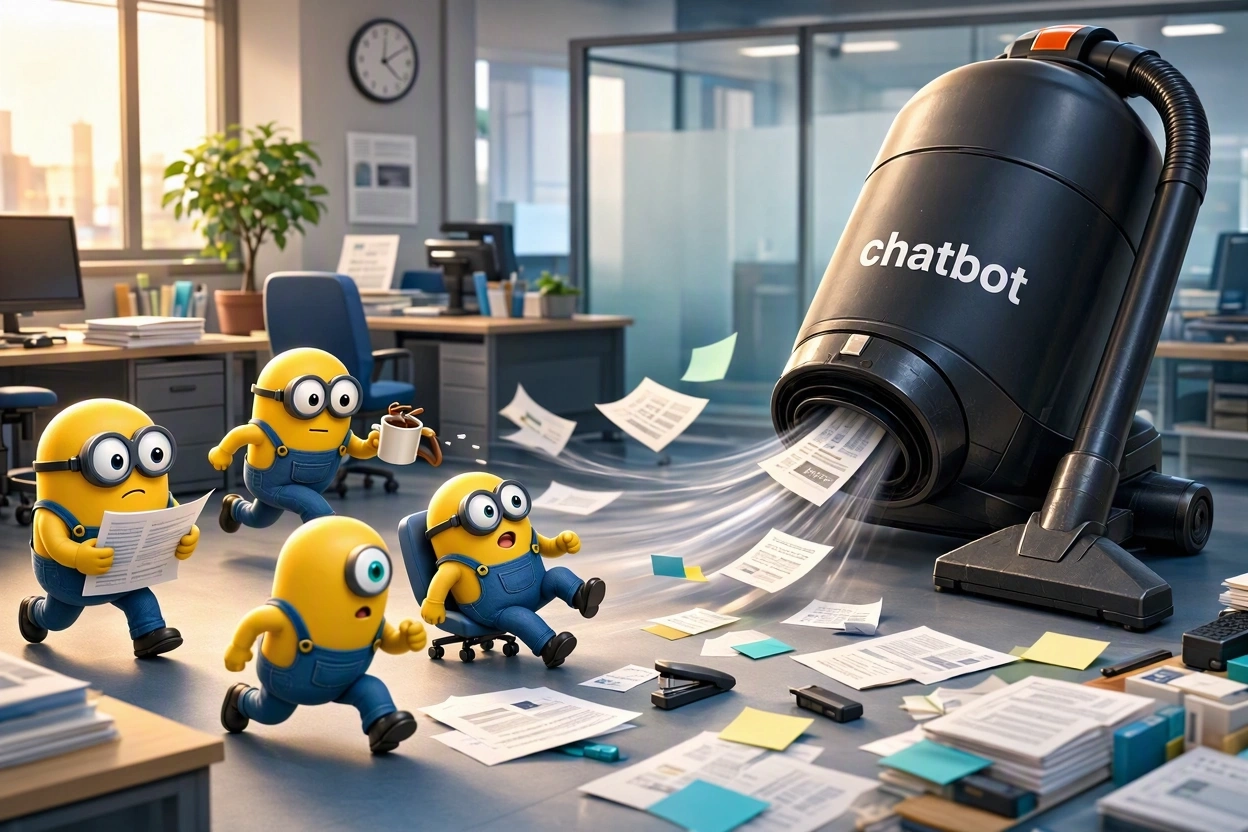
Ogni volta che invochiamo un LLM con una richiesta (prompt, che altro non è che un testo nel nostro linguaggio naturale che esprime ciò che vogliamo ottenere, più eventualmente dei file “allegati” su cui operare), stiamo inviando tutto ad un sistema remoto perché lo elabori e ci fornisca la una risposta. Non è un meccanismo nuovo: i servizi internet lavorano quasi sempre così, e la questione di cosa succede ai dati che inviamo come richiesta si è sempre posta; ma per gli LLM esiste un (ri)utilizzo nuovo: finire nell’addestramento, cioè entrare a far parte dell’enorme calderone di dati da cui vengono attinte le parti che comporranno la risposta, non solo per noi, ma potenzialmente per ogni altro utente dello stesso sistema.
Esempio concreto: se scriviamo una poesia originale con un certo argomento, e la usiamo (copiandola, o caricando un file che la contiene) in una richiesta per un LLM, anche fosse solo per un controllo ortografico, non possiamo escludere che un altro utente dello stesso LLM che fa richiesta su quel dato argomento riceva (da ora all’eternità) all’interno della sua risposta la nostra poesia o parti di essa, anche se non venisse mai pubblicata.
I dati riservati
Anche se ci viene raccontato il contrario, gli LLM non solo non sono intelligenti, ma sono completamente stupidi. Non distinguono un dato da un altro, né possono avere distinzioni sull’importanza o meno di un dato (questa è una prerogativa umana). In sostanza, la ricetta della carbonara che conoscono tutti o le caratteristiche genetiche di un singolo individuo vengono trattate esattamente allo stesso modo: come una sequenza di caratteri (in realtà, come sequenza di token, che sono parole o parti di parole).
E quindi, un dato che è meritevole (per qualsiasi motivo) di riservatezza, se entra a far parte dell’addestramento di un LLM, diventa automaticamente (potenzialmente) pubblico. (potenzialmente perché nessuno sa e può sapere se finirà in una risposta per qualche altro utente; ma sappiamo con certezza che può succedere).
La soluzione
Per evitare ciò esiste una sola, ovvia possibilità: che i dati riservati non vengano utilizzati per addestrare l’LLM. E ciò a sua volta può succedere solo per scelta implementativa del fornitore del sistema LLM.
Capita però che i fornitori degli LLM più noti (e migliori, bisogna riconoscerlo) hanno bisogno di addestrare continuamente i loro modelli, e quindi per non farlo con i dati di utilizzo (cosa che per loro è un danno) vogliono qualcosa in cambio: non stupirà sapere che questo qualcosa è per lo più denaro.
In pratica, se non vogliamo che i nostri dati con cui utilizziamo un LLM finiscano “dentro” lo stesso LLM, dobbiamo ricorrere ad una licenza di utilizzo che escluda contrattualmente questa possibilità, il che quasi sempre corrisponde una tra quelle con i costi più alti.
(in realtà c’è un’altra possibilità, decisamente meno pratica: utilizzare un LLM “locale”, cioè che, diversamente dai consueti sistemi remoti ed accessibili tramite collegamento internet, sia in esecuzione su un nostro computer, su cui siamo noi ad avere il controllo).
E quindi, il GDPR?
Venendo infine al tema della protezione dei dati personali, sappiamo che ci sono una serie di principi da rispettare, tra cui la minimizzazione dei dati, la limitazione delle finalità, e la riservatezza; cioè, i dati personali che trattiamo (ma lo stessa cosa vale per dati non personali ma che non vogliamo far conoscere a chicchessia) non devono finire in mano a chi non ne ha la necessità, e certamente “tutto il mondo” (o almeno gli altri utenti dell’LLM che stiamo utilizzando) non ne fanno parte.
Questo non significa che è vietato utilizzare gli LLM: significa che bisogna selezionare quelli che garantiscono il non riutilizzo dei dati per l’addestramento, e quindi vanno valutati non solo dal punto di vista tecnico ed economico, ma anche dal punto di vista contrattuale. (i più ferrati in materia noteranno che ciò non è poi così diverso dai criteri di selezione di qualsiasi strumento o responsabile del trattamento…)
Ma non basta: oltre che decidere quali LLM utilizzare, bisogna anche impedire che ne vengano utilizzati altri non adeguati (rispetto ai nostri criteri); ma ciò è esattamente ciò che avviene normalmente, cioè che gli addetti (i lavoratori) spesso utilizzano anche con dati di lavoro gli LLM che sono abituati ad usare privatamente. Questa pratica, in ambito GDPR, è una violazione (data breach)! Occorre quindi sensibilizzare, formare e quando necessario sanzionare i lavoratori riguardo a questo aspetto.
LabPrivacy RIPRODUZIONE RISERVATA. Ne è consentito un uso parziale, previa citazione della fonte.


